deepseek
探索未至之境 · 纯强化学习长思考大模型
纯强化学习激发长思考,重构通用推理范式
DeepSeek 摆脱对海量监督微调样本的路径依赖,通过大规模后训练纯强化学习让模型自主掌握验证反思、错误修正和回溯推导能力。在高等数学竞赛、复杂算法编程与多步骤逻辑博弈等高认知场景下展现出超越传统大模型的纵深解答效能。
我们坚守开源初衷,全量公开模型权重、技术架构与训练评测方案,使全球开发者与研究机构能够以更低成本、更高透明度部署新一代人工智能生产力工具。
BENCHMARK PROOFS // 严谨学术基准测试
基于开源评测集标准化自动化打分,客观建立信任,拒绝口号化宣传
PASS@1 ACCURACY METRIC
| 基准测试 / 适用场景 | DeepSeek-R1 (开源模型) | 国际同量级闭源模型 o1 | GPT-4o (通用旗舰) | Claude 3.5 Sonnet |
|---|---|---|---|---|
| AIME 2024 (全美数学竞赛) | 79.8% | 79.2% | 40.0% | 41.7% |
| MATH-500 (权威高阶数学) | 97.3% | 96.4% | 74.6% | 78.3% |
| Codeforces (专业算法竞赛) | 96.3% 百分位 (2029) | 96.6% 百分位 (2061) | 11.0% 百分位 | 71.0% 百分位 |
| MMLU (多学科知识综合) | 90.8% | 91.8% | 88.7% | 88.3% |
| 开源权重透明度 | 完全开放 (MIT / Apache 2.0) | 完全封闭 | 完全封闭 | 完全封闭 |
01. 纯强化学习自主涌现
无需庞大的人工标注引导,模型在超长思维链求解过程中自发探索验证假设,形成严密的解题心智。
02. MLA 架构显存革命
独创多头潜变量注意力压缩技术,大幅降低推理 KV Cache 占用,实现消费级硬件顺畅运行大参数模型。
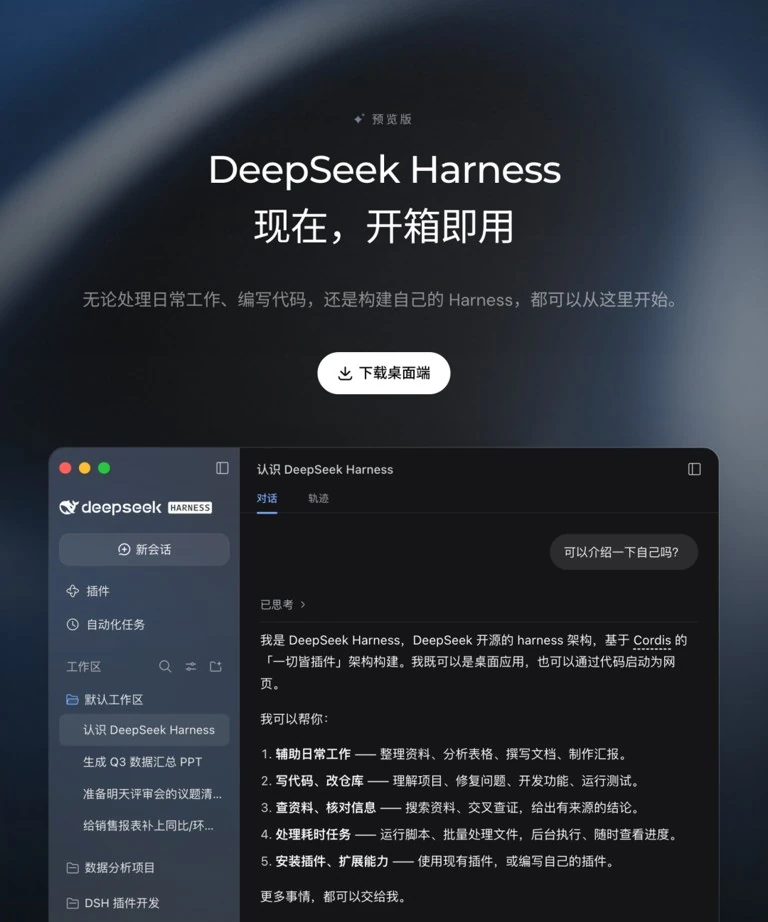
// OPEN WEIGHTS & HARNESS
100% REPRODUCIBLE
100% REPRODUCIBLE
03. 严谨科研生态共享
提供 DeepSeek Harness 自动化评测规范与全流程训练日志,支持全球实验室可验证复现。